Resumo
Introdução: Da perda de contexto à memória persistente em vídeos longos
A frustração é comum em fóruns técnicos como o Reddit: desenvolvedores e entusiastas de automação criam bots no Telegram ou WhatsApp para resumir vídeos longos do YouTube, mas esbarram em uma barreira invisível. O bot entrega um resumo aceitável do vídeo atual, mas esquece completamente o que foi discutido na semana passada. Se o usuário precisa cruzar informações entre três palestras técnicas assistidas no mês anterior, a inteligência artificial falha, pois o histórico se perdeu na volatilidade das conversas.
Esta limitação decorre da própria arquitetura dos modelos de linguagem tradicionais, que lidam com janelas de contexto finitas e tratam cada requisição de forma isolada. Para empresas e profissionais que utilizam o conteúdo de vídeo como base de conhecimento — seja para análise de mercado, suporte técnico ou estudos aprofundados —, essa amnésia digital representa uma perda massiva de produtividade.
A solução definitiva para este problema não reside apenas em trocar de modelo de IA, mas em redesenhar a infraestrutura de dados. Ao combinar a capacidade de orquestração do n8n, a precisão de busca de um banco de dados vetorial como o Qdrant e a flexibilidade do protocolo Model Context Protocol (MCP), torna-se possível construir um assistente capaz de consultar transcrições inteiras e retornar respostas exatas acompanhadas dos timestamps correspondentes.
O Desafio dos Resumos de Vídeo e as Limitações de Contexto
Desenvolver soluções de IA voltadas para consumo de mídia audiovisual exige lidar com um volume massivo de dados não estruturados. Uma única palestra de duas horas no YouTube gera milhares de tokens em texto transcrito. Quando múltiplos vídeos são injetados em um fluxo de atendimento ou em um repositório de conhecimento pessoal, o volume supera rapidamente a capacidade de processamento imediato dos LLMs convencionais.
O feedback recorrente da comunidade de engenharia de software aponta para a necessidade de ir além do resumo estático. O modelo precisa realizar uma passada estruturada, particionando o conteúdo em blocos lógicos — processo conhecido como chunking — e indexando essas informações de forma que o sistema saiba exatamente em qual segundo do vídeo determinado conceito foi abordado.
Por que a IA convencional falha com conteúdos longos?
Os Modelos de Linguagem Grande (LLMs) operam sob restrições estritas de tamanho de janela de contexto. Embora modelos recentes anunciem suporte a milhões de tokens, enviar transcrições brutas e extensas a cada interação gera dois problemas críticos: custos operacionais proibitivos de API e a degradação da precisão analítica — fenômeno onde o modelo ignora informações localizadas no meio do texto (o problema do lost in the middle).
Sem uma base vetorial intermediária, o sistema tenta adivinhar ou resumir de forma genérica trechos que exigem precisão cirúrgica. A ausência de indexação por vetores impede que o agente execute buscas semânticas eficientes. Consequentemente, perguntas específicas sobre declarações feitas aos 45 minutos de um vídeo de três horas resultam em respostas vazias ou alucinações.
| Abordagem / Arquitetura | Vantagens | Desvantagens | Complexidade de Implementação |
|---|---|---|---|
| Resumo Simples via LLM (Sem Memória) | Rápido e barato de implementar | Perde o contexto histórico; incapaz de buscar trechos específicos | Baixa |
| Bot com Chunking e Base Vetorial (Qdrant) | Permite buscas semânticas profundas e recuperação por timestamp | Exige configuração de banco vetorial e embeddings | Média-Alta |
| Abordagem Híbrida (n8n + Qdrant + MCP) | Memória persistente total, busca avançada via Claude e automação fluida | Requer integração entre múltiplos serviços e gerenciamento de API | Alta |
A Solução Definitiva: Arquitetura de Integração com n8n, Qdrant e MCP
Para superar as barreiras de contexto, implementa-se um pipeline orientado a eventos utilizando o n8n como motor de integração. O processo inicia quando o usuário envia um link do YouTube para o canal do Telegram configurado.
O n8n captura o link, aciona um nó de extração para baixar as legendas ou transcrições do vídeo e encaminha o texto bruto para um serviço de divisão (chunking). Cada bloco de texto gerado passa por um modelo de embeddings (como os da OpenAI ou Hugging Face), transformando sentenças em vetores numéricos densos. Esses vetores são armazenados de forma persistente no Qdrant, associados aos metadados do vídeo, incluindo o ID e os carimbos de tempo (timestamps).
Na camada de consulta, o padrão Model Context Protocol (MCP) atua como uma ponte padronizada. Quando o usuário interage com o assistente (utilizando o Claude, por exemplo), o protocolo permite que a IA consulte diretamente a base vetorial do Qdrant em tempo de execução, recuperando exclusivamente os trechos relevantes e estruturando uma resposta fundamentada.
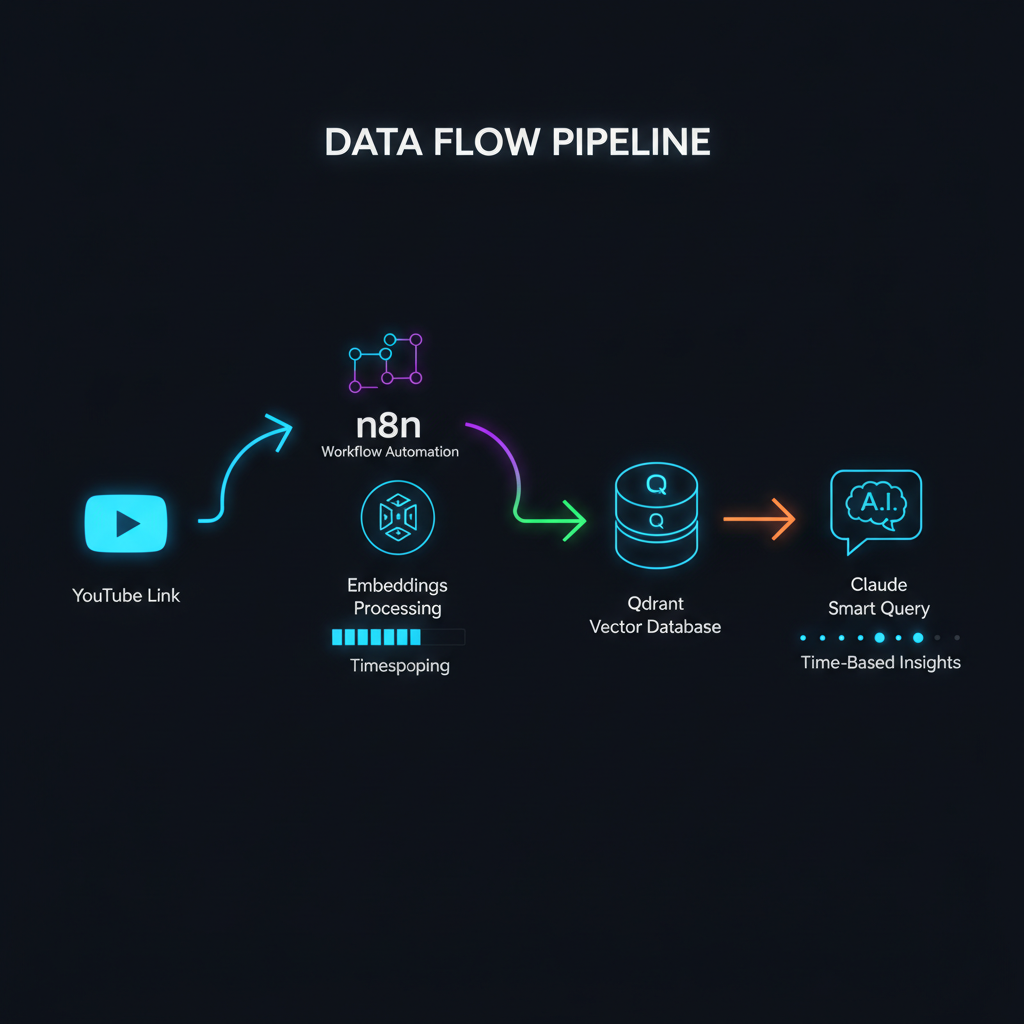
graph TD
    A[Link do YouTube no Telegram] --> B[n8n: Extração de Transcrição]
    B --> C[Processamento & Chunking de Texto]
    C --> D[Geração de Embeddings]
    D --> E[Armazenamento Vetorial no Qdrant]
    F[Consulta do Usuário via Claude] --> G[MCP Protocol: Busca Semântica]
    G --> E
    E --> H[Resposta Precisa com Timestamp]
Implementação Prática e Benefícios da Memória Vetorial
A estruturação dos nós no n8n exige atenção especial ao particionamento das legendas. Utilizar nós de manipulação de código (JavaScript ou Python dentro do n8n) para agrupar transcrições em blocos de 500 a 1000 caracteres, mantendo a sobreposição (overlap) de 100 caracteres, garante que nenhuma frase seja cortada abruptamente no meio, preservando a semântica do conteúdo.
No Qdrant, a definição da coleção deve contemplar o tamanho correto dos vetores gerados pelo modelo de embeddings escolhido (por exemplo, 1536 dimensões para o `text-embedding-3-small`). Além disso, indexar os metadados como o link do vídeo e o timestamp inicial permite que o fluxo retorne não apenas o texto explicativo, mas o link direto para o segundo exato onde o assunto foi discutido.
Do ponto de vista operacional, esta arquitetura otimiza drasticamente o consumo de tokens. Em vez de injetar horas de vídeo na janela de contexto a cada nova pergunta, a busca vetorial recupera apenas os três ou quatro fragmentos mais relevantes do Qdrant, injetando no prompt um volume mínimo de dados altamente qualificados.
Conclusão e Próximos Passos
A transição de um bot de resumo convencional para um assistente com memória de longo prazo baseada em vetores transforma radicalmente a utilidade de conteúdos audiovisuais em fluxos de trabalho corporativos e de pesquisa. A união do n8n para automação, Qdrant para persistência vetorial e MCP para padronização de consultas elimina os gargalos de contexto e garante precisão cirúrgica nas respostas.
Implementar este pipeline em sua infraestrutura capacita sua operação a extrair valor contínuo de qualquer volume de dados em vídeo. Integre as etapas descritas em seu ambiente n8n, ajuste os parâmetros de chunking conforme a densidade técnica dos vídeos que você consome e estabeleça uma base de conhecimento verdadeiramente inteligente e perpétua.
[CATEGORIZACAO: tecnologia]