O planejamento de conteúdo orgânico frequentemente esbarra em uma barreira operacional invisível: o tempo gasto na mineração manual de termos. Profissionais de marketing e criadores de conteúdo dedicam horas coletando sugestões de ferramentas de busca, cruzando dados de concorrentes e organizando planilhas antes de produzir a primeira linha de um artigo. Esse processo repetitivo limita a capacidade de escala de portais digitais e reduz a eficiência das equipes de conteúdo.
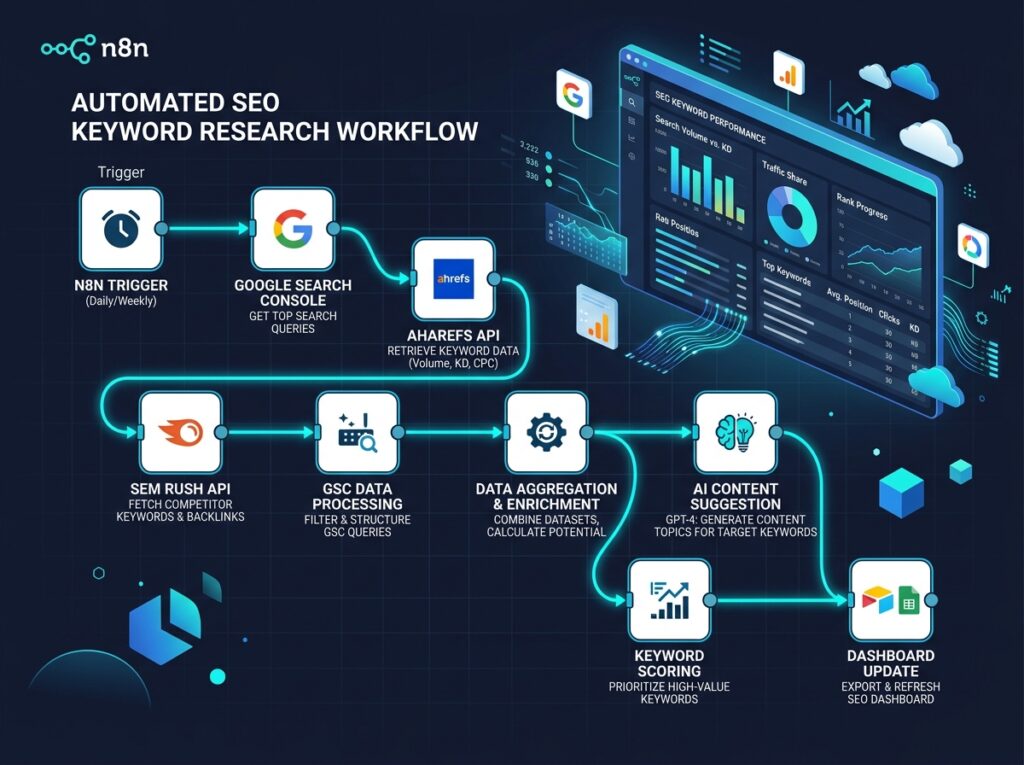
A automação de fluxos de trabalho oferece uma alternativa viável para eliminar essa fricção. Ao integrar ferramentas de orquestração no-code com APIs de busca e inteligência artificial, é possível estruturar um pipeline contínuo que minera, categoriza e armazena palavras-chave de cauda longa de forma automatizada. A implantação desta infraestrutura reduz o esforço manual a zero, permitindo que o foco da equipe seja direcionado inteiramente à qualidade estratégica do conteúdo publicado.
O Gargalo da Pesquisa de Palavras-Chave Tradicional
A dependência exclusiva de métodos manuais para a descoberta de termos de busca gera um custo operacional oculto severo. Analistas de SEO frequentemente abrem dezenas de abas no navegador, inserem termos semente nas barras de pesquisa, copiam sugestões de autocomplete e colam manualmente em planilhas intermináveis. Esse modelo de trabalho não apenas consome horas valiosas, mas também introduz erros humanos e viés analítico, ignorando termos de cauda longa relevantes que exigiriam uma varredura de dados muito mais ampla.
Além do fator tempo, o orçamento dedicado a suítes de SEO corporativas representa outro obstáculo. Ferramentas tradicionais cobram mensalidades elevadas que muitas vezes excedem o orçamento de blogs em fase de crescimento ou agências focadas em eficiência de custos. A automação com ferramentas open-source ou de baixo custo de execução altera essa dinâmica, viabilizando a extração de dados brutos diretamente das fontes de busca e o processamento desses dados sob medida.
O Desafio de Encontrar Palavras-Chave Semente e Long-Tail
A extração de termos de alta intenção comercial e informacional exige o cruzamento de dados de autocomplete com o comportamento real de busca do público. O principal desafio técnico reside na formatação e na limpeza desses dados em larga escala. Sem um sistema programático, filtrar duplicatas, analisar a intenção de busca (informacional, navegacional, transacional) e agrupar os termos por relevância semântica torna-se uma tarefa inviável para uma única pessoa gerenciar semanalmente.
A implementação de uma arquitetura baseada em n8n resolve essa limitação ao automatizar a coleta e a estruturação prévia dos dados. O fluxo executa requisições programadas, extrai as sugestões correlacionadas e as direciona para uma camada de inteligência artificial que realiza a clusterização semântica automaticamente.
| Método de Pesquisa | Tempo Médio Gasto | Custo Operacional | Nível de Escalabilidade |
|---|---|---|---|
| Pesquisa Manual (Google/Planilhas) | 4 a 6 horas por pauta | Baixo (Tempo da equipe) | Muito Baixo |
| Ferramentas Corporativas Tradicionais | 1 a 2 horas por pauta | Alto (Assinaturas caras) | Médio |
| Pipeline Automatizado com n8n | Menos de 5 minutos | Baixo/Médio (API e infra) | Alto / Ilimitado |
Construindo o Pipeline de SEO com n8n: Passo a Passo
A construção de um fluxo de automação de SEO no n8n exige a estruturação lógica de nós interconectados que conversam entre si por meio de requisições HTTP e processamento de dados em formato JSON. O processo inicia-se com a definição de uma palavra-chave semente armazenada em uma tabela de controle ou disparada via Webhook.
O primeiro bloco do fluxo utiliza um nó de requisição HTTP (HTTP Request Node) para consultar endpoints de sugestão de busca públicos ou APIs especializadas em extração de dados de mecanismos de busca. O payload de resposta retorna centenas de termos correlacionados, sinônimos e perguntas frequentes feitas pelos usuários.
Na etapa seguinte, o n8n direciona o array de dados brutos para um nó de inteligência artificial (como a integração com a API da OpenAI ou Anthropic). A instrução (prompt) configurada no nó orienta o modelo de linguagem a atuar como um Arquiteto de SEO: o algoritmo analisa a lista, remove termos sem relevância comercial, classifica cada palavra-chave por intenção de busca e agrupa o conteúdo em categorias temáticas estruturadas.
graph TD
    A[Início: Palavra-Chave Semente] --> B[Node n8n: Requisição API de Busca/Autocomplete]
    B --> C[Node n8n: Coleta de Dados de Concorrentes]
    C --> D[Node n8n: Processamento e Filtro com IA]
    D --> E[Saída: Tabela Organizada com Long-Tails]
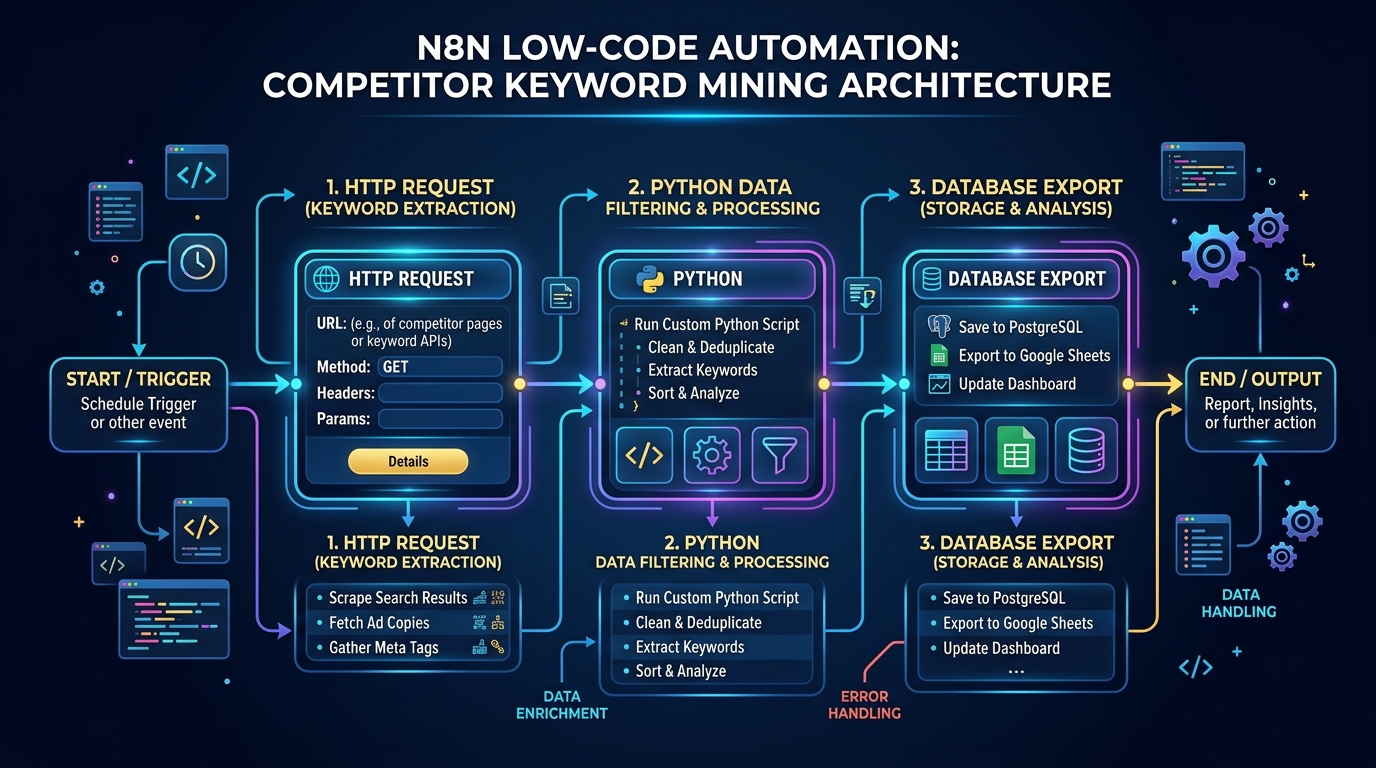
O resultado final desse pipeline é direcionado automaticamente para o banco de dados da empresa, como Supabase, Airtable ou Notion, alimentando o calendário editorial com pautas validadas e prontas para a produção de conteúdo.
Vantagens de Escalonar o SEO com Ferramentas No-Code e IA
A adoção de arquiteturas no-code combinadas com modelos de linguagem descentraliza o acesso a recursos tecnológicos avançados. Equipes que antes dependiam de suporte de engenharia de software para coletar e analisar dados de mercado agora conseguem desenhar seus próprios fluxos de integração em poucas horas.
Do ponto de vista operacional, a automação elimina o atrito inicial do planejamento estratégico. Blogs corporativos e portais de notícias ganham agilidade para identificar tendências de busca em tempo real, respondendo a pautas quentes antes da concorrência e mantendo uma cadência de publicação otimizada sem a necessidade de expansão linear da equipe de planejamento.
Conclusão e Próximos Passos
A transição de processos manuais para fluxos automatizados de pesquisa de palavras-chave representa uma evolução indispensável para operações digitais que buscam eficiência e crescimento sustentável. A eliminação de tarefas repetitivas libera recursos intelectuais valiosos para o desenvolvimento de estratégias de conteúdo mais profundas e assertivas.