Engenheiros de dados e cientistas lidam rotineiramente com o desafio de escalar pipelines analíticos sem incorrer em custos exponenciais de infraestrutura em nuvem. Historicamente, bibliotecas orientadas a frameworks em Python, como o Pandas, apresentavam gargalos severos de memória ao processar arquivos que excediam a capacidade da RAM disponível, forçando equipes a recorrerem a soluções distribuídas complexas como Apache Spark para volumes de dados que poderiam rodar em uma única máquina robusta.
O lançamento do Polars 2.0 streaming engine consolida a resposta da comunidade open-source para o processamento eficiente em memória e fora dela (out-of-core). Construído sobre a linguagem Rust e alinhado ao ecossistema Apache Arrow, o Polars redefine a velocidade de execução de consultas analíticas. A chegada do suporte nativo a SQL e melhorias expressivas no motor de execução reduzem o tempo de processamento de horas para segundos, otimizando o custo de servidores de processamento e simplificando a arquitetura de engenharia de dados.
O Que Muda com o Motor de Streaming e Processamento Out-of-Core no Polars 2.0
O processamento out-of-core refere-se à capacidade de um motor de dados manipular e transformar datasets significativamente maiores do que a memória física (RAM) da máquina executora. Em versões anteriores de ferramentas tradicionais, carregar um arquivo Parquet de 100 GB em um ambiente com 32 GB de RAM resultava em um erro imediato de Out of Memory (OOM).
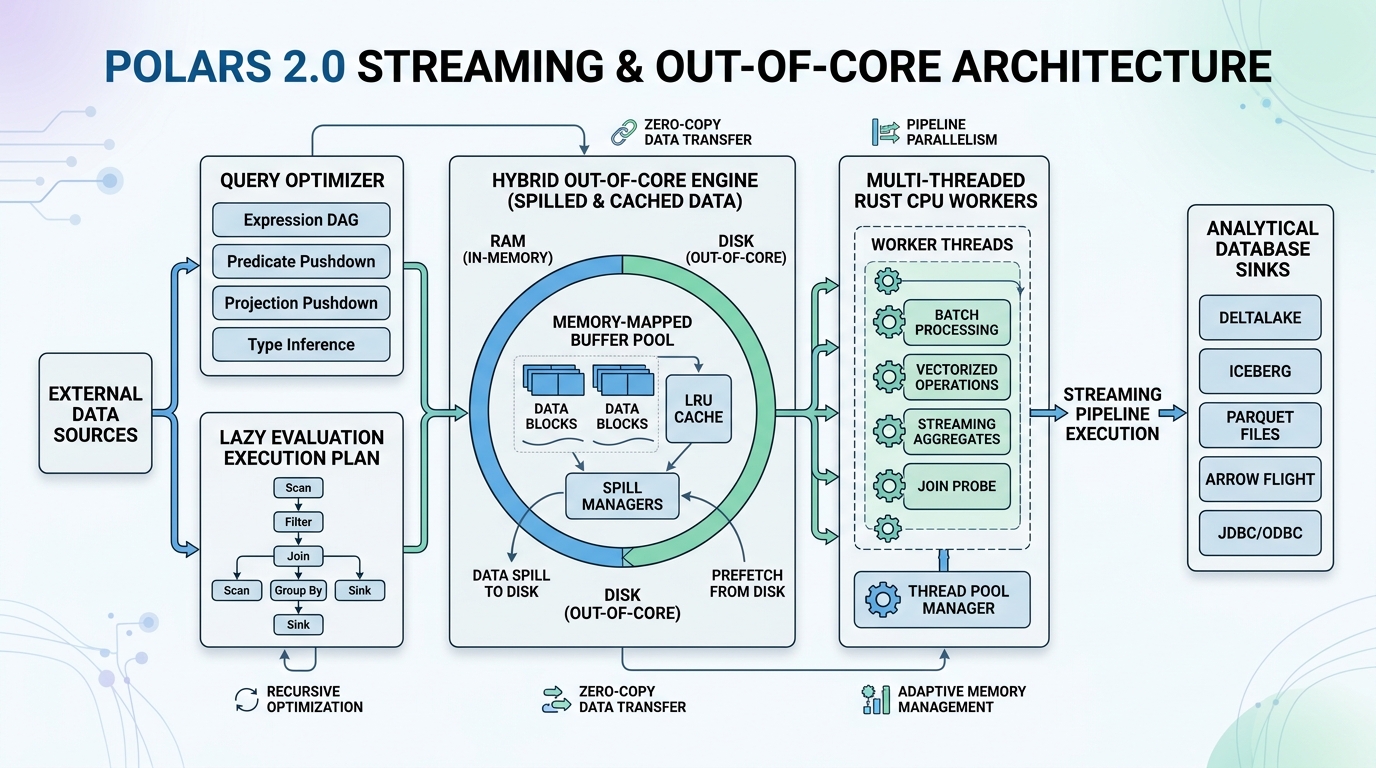
O motor de streaming do Polars 2.0 aborda este problema segmentando o dataset em lotes gerenciáveis que fluem através de um grafo de execução otimizado. As operações de agregação, filtragem e junção (joins) são aplicadas diretamente no fluxo de dados (pipeline), permitindo que o sistema descarte partições desnecessárias antes de consolidar o resultado final em disco ou memória.
Ganhos de Performance e Eficiência de Recursos
A arquitetura do Polars 2.0 aproveita a paralelização de múltiplos núcleos de CPU de forma mais agressiva e eficiente que seus antecessores. Por ser desenvolvido em Rust, o motor elimina a sobrecarga (overhead) do coletor de lixo (garbage collector) do Python e utiliza gerenciamento manual de memória baseado no padrão Apache Arrow.
Essa eficiência se manifesta de maneira evidente quando combinada com a avaliação tardia (lazy evaluation). Quando um fluxo de dados é construído em modo lazy, o otimizador do Polars analisa toda a árvore de operações antes de executar qualquer linha de código. Isso permite reordenar filtros para executá-los o mais cedo possível (predicate pushdown) e selecionar apenas as colunas estritamente necessárias (projection pushdown), minimizando o tráfego de I/O em disco.
| Funcionalidade / Recurso | Pandas tradicional | Polars (Versões Antigas) | Polars 2.0 (Streaming & Out-of-Core) |
|---|---|---|---|
| Limite de Memória | Limitado estritamente pela RAM | Alto desempenho em RAM | Datasets maiores que a RAM (Out-of-core nativo) |
| Motor de Streaming | Não possui | Parcial / Em evolução | Altamente otimizado e padrão em operações complexas |
| Suporte a SQL | Limitado / Requer bibliotecas externas | Limitado / Funcionalidades básicas | First-class SQL support integrado ao motor Rust |
Arquitetura e Integração: Como Funciona o Fluxo de Dados no Polars 2.0
A infraestrutura do Polars 2.0 foi desenhada para unificar a flexibilidade analítica do Python com a performance de baixo nível do Rust. Quando uma consulta é submetida — seja via API nativa de DataFrames ou utilizando as novas interfaces de SQL —, o otimizador interno construi um plano lógico de execução.
graph TD
    A[Fonte de Dados: CSV / Parquet / SQL] --> B[Polars 2.0 Optimizer]
    B --> C{Dataset cabe na RAM?}
    C -- Sim --> D[Processamento In-Memory vetorizado]
    C -- Não --> E[Motor de Streaming Out-of-Core]
    D --> F[Resultado Final / Exportação]
    E --> F[Resultado Final / Exportação]
O ecossistema interno utiliza o formato de memória columnar do Apache Arrow, o que significa que os dados não precisam ser serializados ou desserializados ao passarem entre diferentes etapas do pipeline de processamento. Caso o otimizador identifique que o dataset excede o limite operacional da RAM, o fluxo é automaticamente desviado para o motor de streaming out-of-core, garantindo estabilidade e impedindo quedas abruptas de serviços em produção.
Primeiros Passos e Migração para o Polars 2.0
A adoção do Polars 2.0 em ambientes de produção exige atenção à refatoração de códigos legados. Embora a API mantenha compatibilidade com grande parte das sintaxes anteriores, o aproveitamento pleno das capacidades de streaming requer a conversão de DataFrames avaliados ansiosamente (eager) para o modo lazy.
Para iniciar um pipeline utilizando o motor de streaming e a execução otimizada, utilize a seguinte estrutura base em Python:
import polars as pl

# Leitura de um dataset massivo em modo lazy (sem carregar na RAM)
q = (
    pl.scan_parquet("s3://meu-bucket-dados/transacoes_2026.parquet")
    .filter(pl.col("status") == "concluido")
    .group_by("categoria_id")
    .agg([
        pl.col("valor").sum().alias("receita_total"),
        pl.col("valor").mean().alias("ticket_medio")
    ])
    .sort("receita_total", descending=True)
)

# Execução utilizando o novo motor de streaming do Polars 2.0
df_resultado = q.collect(streaming=True)

print(df_resultado.head(10))
Integração Nativa com SQL
Outro avanço expressivo no Polars 2.0 é o suporte a consultas SQL executadas diretamente sobre os DataFrames em memória ou escaneados de arquivos externos. Esta funcionalidade reduz a barreira de entrada para analistas de dados que já dominam a linguagem SQL, permitindo consultas complexas sem a necessidade de instanciar bancos de dados relacionais tradicionais para análises ad-hoc:
ctx = pl.SQLContext()
ctx.register("transacoes", pl.scan_parquet("transacoes_2026.parquet"))

query_resultado = ctx.execute("""
    SELECT categoria_id, SUM(valor) as total
    FROM transacoes
    WHERE ano = 2026
    GROUP BY categoria_id
    ORDER BY total DESC
    LIMIT 5
""")

df_sql = query_resultado.collect(streaming=True)
Ao refatorar códigos legados baseados em versões antigas, certifique-se de validar se as funções personalizadas (UDFs em Python) aplicadas via `.apply()` podem ser substituídas por expressões nativas vetorizadas do Polars. O uso de funções Python puras dentro de loops ou mapeamentos degrada severamente a performance do motor baseado em Rust, anulando os ganhos de paralelização.
Conclusão
A consolidação do Polars 2.0 streaming engine marca um ponto de inflexão na engenharia de dados moderna. Ao eliminar a falsa dicotomia entre processamento local rápido e processamentos distribuídos complexos, a ferramenta capacita equipes técnicas a processarem volumes massivos de dados utilizando infraestrutura enxuta e de baixo custo. A união entre execução assíncrona, gerenciamento inteligente de memória out-of-core e suporte nativo a SQL posiciona o Polars como um componente indispensável para pipelines analíticos de alta performance.